Hoe Liquipedia Dota 2-matchdata vertaalt in bruikbare meta-inzichten

Liquipedia maakt van Dota 2-matchen iets heel concreets: meta-inzichten die je kunt terugzien in cijfers. Op social media lijkt “wat sterk is” vaak een eindeloze Reddit-discussie, maar onder de motorkap draait het meestal om spreadsheetwerk met pickrates, winrates per lane, item timings en objective control. Die info komt niet uit het niets, want API’s, toernooiverslagen en replays leveren een stroom aan data die vervolgens strak wordt geordend.
De meta is daardoor zelden puur smaak of hype, en vaker een reactie op meetbare resultaten. Daarbij gaat het vooral om welke statistieken echt iets zeggen over of een plan werkt. Analisten, teams en de community volgen dat in real time, waardoor een “mening” vaak pas volgt nadat een patroon al zichtbaar is.
Van ruwe matchdata naar bruikbare patronen
Liquipedia leunt op gestructureerde brondata om analyses op te bouwen. Een officiële wedstrijd levert een replay op met tijdlijnen van ganks, wards, roshan-attempts en item purchases, en dat is goud voor wie wil snappen waarom een game kantelt. Via de Steam API en extra scrapers worden die logs omgezet in tabellen die je onderling kunt vergelijken, ook over meerdere patches.
Normalisatie is daarbij het breekpunt, omdat patchcontext alles bepaalt. Een winrate op patch 7.35 kun je niet één op één naast patch 7.36 leggen als een held intussen is herwerkt. Pas daarna ontstaat de dataset waar teams en analisten serieus op durven bouwen.
Met die opgeschoonde data ga je pas echt zinnige vragen stellen. Een pickrate van 42% op positie 4 zegt iets totaal anders dan dezelfde pickrate verspreid over vijf posities, omdat rol en lane de interpretatie bepalen. Daarom wordt er meestal gefilterd op lane assignment, skill bracket en patch window, anders blijven er gemiddelden over waar niemand beter van wordt.
Welke statistieken écht iets voorspellen
Niet elke stat is even nuttig, ook al ziet het er flashy uit na de match. GPM en XPM lijken indrukwekkend op het post-match scherm, maar leggen vaak niet uit waarom een team wint. Statistieken die consistent met victory meebewegen zijn meestal specifieker en minder “sexy”, maar wel betrouwbaarder.
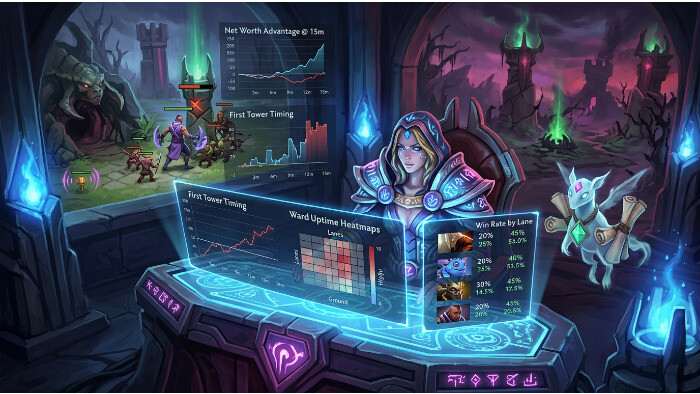
- Objective timing draait om het moment dat de eerste tier-1 tower valt en welk team daarna de map in handen krijgt.
- Ward uptime op high-ground en jungle entrances zegt veel over vroege controle, omdat vision in de eerste tien minuten gank-succes beter voorspelt dan kills.
- Item timings op kernitems laten zien hoe hard de mid-game kan versnellen, want een Radiance op minuut 18 speelt anders dan dezelfde aankoop op minuut 24.
- Net worth-verschil op minuut 15 hangt opvallend sterk samen met de uiteindelijke uitslag en wordt daarom veel gebruikt in evaluaties.
- Smoke-usage en rotatiefrequentie van position 4 en 5 maken tempo meetbaar, omdat actieve supports vaker het speelveld verplaatsen.
Deze metrics werken vooral omdat ze gedrag meten in plaats van alleen de eindscore. Kills zijn vaak het gevolg van iets anders dat al mis ging, terwijl objective control en vision eerder de oorzaak zijn. Zodra je dat verschil scherp hebt, kijk je anders naar een draft dan iemand die vooral op de scoreline afgaat.
Waarom de meta vaker data is dan mening
Pro-teams reageren snel als een trend hard wordt onderbouwd met cijfers. Stijgt een held in drie dagen van 48% naar 54% winrate in Divine en Immortal brackets, dan blijft dat zelden onopgemerkt in scrims en drafts. Dat komt niet doordat iemand op Twitter hard roept dat een hero “OP” is, maar doordat teamanalisten precies dezelfde datasets bekijken.
Liquipedia maakt die beweging zichtbaar door tournament brackets te koppelen aan hero statistics per team. Daardoor zie je de feedbackloop bijna live ontstaan, met picks die vaker winnen, vervolgens meer bans trekken en later weer uit beeld verdwijnen zodra counters opduiken. Sinds patches sneller na majors komen, is die cyclus korter geworden en levert data-gedreven bijsturen vaak sneller resultaat op dan pure intuïtie.
Hoe teams drafts bouwen op cijfers
Bij topteams is draften de afgelopen jaren flink veranderd. Captains zitten niet meer alleen met een gevoel of een “comfort pool”, maar met scouts ernaast die SuperBigWin gaming artikelen en draftanalyse-tools open hebben en matchups uit Liquipedia-datasets filteren. Een pick gaat dan niet alleen over individuele power, maar ook over synergie en een complete counter-matrix.
In de praktijk start zo’n draft met één kernvraag, welke win-condition wil je spelen en welke heroes versterken die tegen deze tegenstander? Data geeft richting, zeker als patronen keer op keer terugkomen in replays. Wint Team A in de laatste tien wedstrijden 70% met early rotations rond minuut 8, dan snapt Team B dat vision rond de wildcamps meteen bovenaan het lijstje staat, en dat is te herleiden tot replays die eindeloos zijn teruggekeken.
Wat betekent dit voor de gemiddelde pub-speler?
De stap van pro naar pubs voelt groot, maar de basisprincipes blijven verrassend bruikbaar. Je hebt geen analistenteam nodig om matchdata in je eigen ranked games toe te passen, zolang je weet welke signalen je moet zoeken. Na een pot begint verbetering meestal bij het terugkijken met een doel, niet bij het herbeleven van die ene mislukte fight.
Check daarom niet alleen je KDA, maar kijk ook naar ward placements, je GPM in de eerste tien minuten en hoe vaak je meedoet aan objectives. Dat zijn acties die je direct kunt trainen en die in data ook echt terugkomen. Replays zijn voor iedereen beschikbaar, terwijl Dotabuff en Stratz met filters werken die dicht in de buurt komen van wat analisten gebruiken.
Praktische lessen uit de data
In geaggregeerde matchdata komen een paar inzichten steeds opnieuw bovendrijven, ongeacht skill bracket. Ze blijven staan omdat ze over fundamentals gaan en niet over één specifieke held die toevallig in de patch sterk is. Neem ze als checklist als je je eigen games wilt ontleden.
- Vision wint games vaker dan mechanics en in Ancient-brackets en hoger is ward uptime een van de sterkste voorspellers van winrate per support-speler.
- Objective focus verslaat kill focus want teams die na een teamfight pushen in plaats van blijven jagen, winnen significant vaker.
- Item timing matters meer dan item choice en een BKB op minuut 20 is vaak waardevoller dan een “optimaal” item pas op minuut 28.
- Lane assignment is draft-afhankelijk en dezelfde held op dezelfde positie kan tot 15% winrate verschillen door de synergie in de draft.
Die punten klinken bekend, maar ze blijven terugkomen omdat de cijfers ze steeds opnieuw bevestigen. Elke patch verschuift het decor, terwijl tempo, vision en economy als onderlaag verrassend stabiel blijven, net zoals een extra doorgang in CS2 de routes wijzigt zonder alle fundamentals te herschrijven. Daardoor kun je met dezelfde meetlat ook na een balance update nog steeds nuttig terugkijken.
De grenzen van data-gedreven analyse
Data vertelt veel, maar niet het hele verhaal. Een winrate van 55% kan scheefgetrokken zijn door een klein aantal games van een paar topteams, waardoor de sample simpelweg te smal is. Bij patches met minder dan twee weken aan matchdata worden conclusies sowieso wankel, zeker als een held net opnieuw is gebalanceerd en iedereen nog aan het zoeken is.
Ook de menselijke factor laat zich lastig in tabellen vangen. Teamchemie, draft-creativiteit en de vorm van individuele spelers kunnen een hero die statistisch zwak oogt toch ineens een winning pick maken. Topteams gebruiken data daarom als startpunt en leggen er context naast, precies waarom platforms zoals Liquipedia zo handig zijn: je krijgt de grondstoffen, niet een kant-en-klare conclusie.
Zie je weer een discussie over wat sterk is in de huidige patch, dan helpt het om te letten op de onderbouwing. De speler die cijfers kan combineren met gevoel heeft een voordeel, maar de basis komt opvallend vaak neer op dezelfde stats die iedereen kan opzoeken. De meta is dus geen mysterie, het is een dataset met gevolgen.
Bijgewerkt: 01.11.2026